구글이 AI 평가에 이중맹검을 도입한 이유…벤치마크 오염 논란을 다시 보는 법
AI 모델의 성능표를 볼 때 보통 가장 먼저 확인하는 것은 점수입니다.
하지만 같은 문제를 미리 접한 모델과 처음 보는 모델을 같은 시험지로 비교한다면, 그 점수는 정말 공정하다고 할 수 있을까요?
최근 구글이 암호화 기술을 활용한 AI 모델 이중맹검 평가를 시범 운영한다는 소식이 나온 이유도 여기에 있습니다.
이번 소식은 새로운 모델 출시나 성능 순위 발표가 아닙니다.
AI 경쟁에서 점수를 만드는 평가 방식 자체를 다시 살펴보게 하는 업계 동향입니다.
구글이 시범 운영하는 평가 방식
AI타임스 보도에 따르면 구글은 평가 전에 문제 데이터가 모델에 미리 학습되는 현상, 이른바 ‘벤치마크 오염’을 줄이기 위해 암호화 기술을 활용한 이중맹검 평가를 시범 운영하고 있습니다.
핵심은 평가에 사용될 문제와 모델이 사전에 직접 접촉하는 가능성을 낮추는 데 있습니다.
다만 현재 공개된 범위만으로는 사용한 암호 기술의 정확한 명칭, 참여 모델, 평가 세트, 시범 운영 결과까지 알 수 없습니다.
따라서 이 소식을 구글 모델의 성능 우위로 읽기보다는, 평가의 독립성과 신뢰성을 높이려는 실험으로 이해하는 편이 정확합니다.
이중맹검은 일반 평가와 무엇이 다른가
일반적인 평가에서는 시험 문제와 평가 조건을 운영 주체가 관리하고, 모델이 어떤 시험을 치르는지 일부 정보가 알려질 수 있습니다.
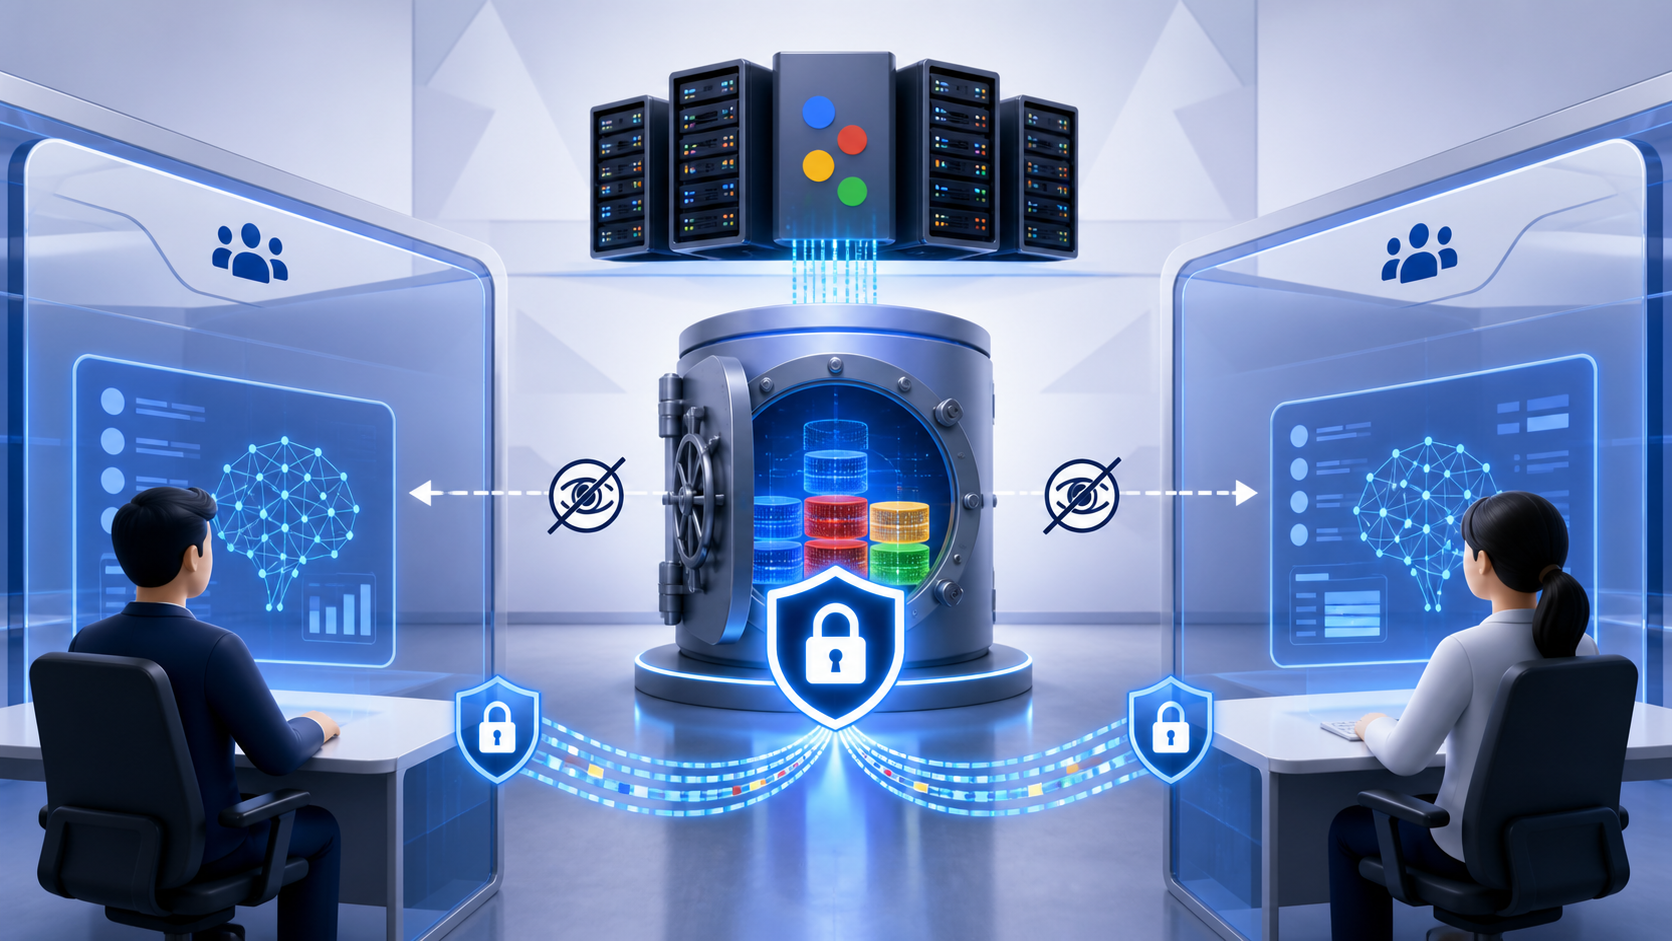
이중맹검은 평가에 관여하는 쪽이 서로의 중요한 정보를 모두 알기 어렵게 만드는 방식입니다.
의료 임상시험에서 환자와 연구자가 어떤 처치를 받았는지 모르게 하는 원리와 비슷하게 이해하면 쉽습니다.
AI 평가에 적용하면 문제를 관리하는 쪽과 모델을 실행하는 쪽 사이에 정보 노출을 줄이는 장치를 둘 수 있습니다.
모델이 문제를 미리 학습했는지, 평가 운영자가 특정 모델에 유리한 조건을 만들었는지에 대한 의심을 줄이는 데 도움이 될 수 있는 구조입니다.
중요한 점은 ‘이중맹검’이라는 이름만으로 평가가 완전히 공정해지는 것은 아니라는 사실입니다.
어떤 문제를 사용했는지, 채점 기준은 무엇인지, 실행 환경이 동일했는지까지 함께 공개되어야 결과를 제대로 해석할 수 있습니다.
벤치마크 오염이 점수를 흔드는 이유
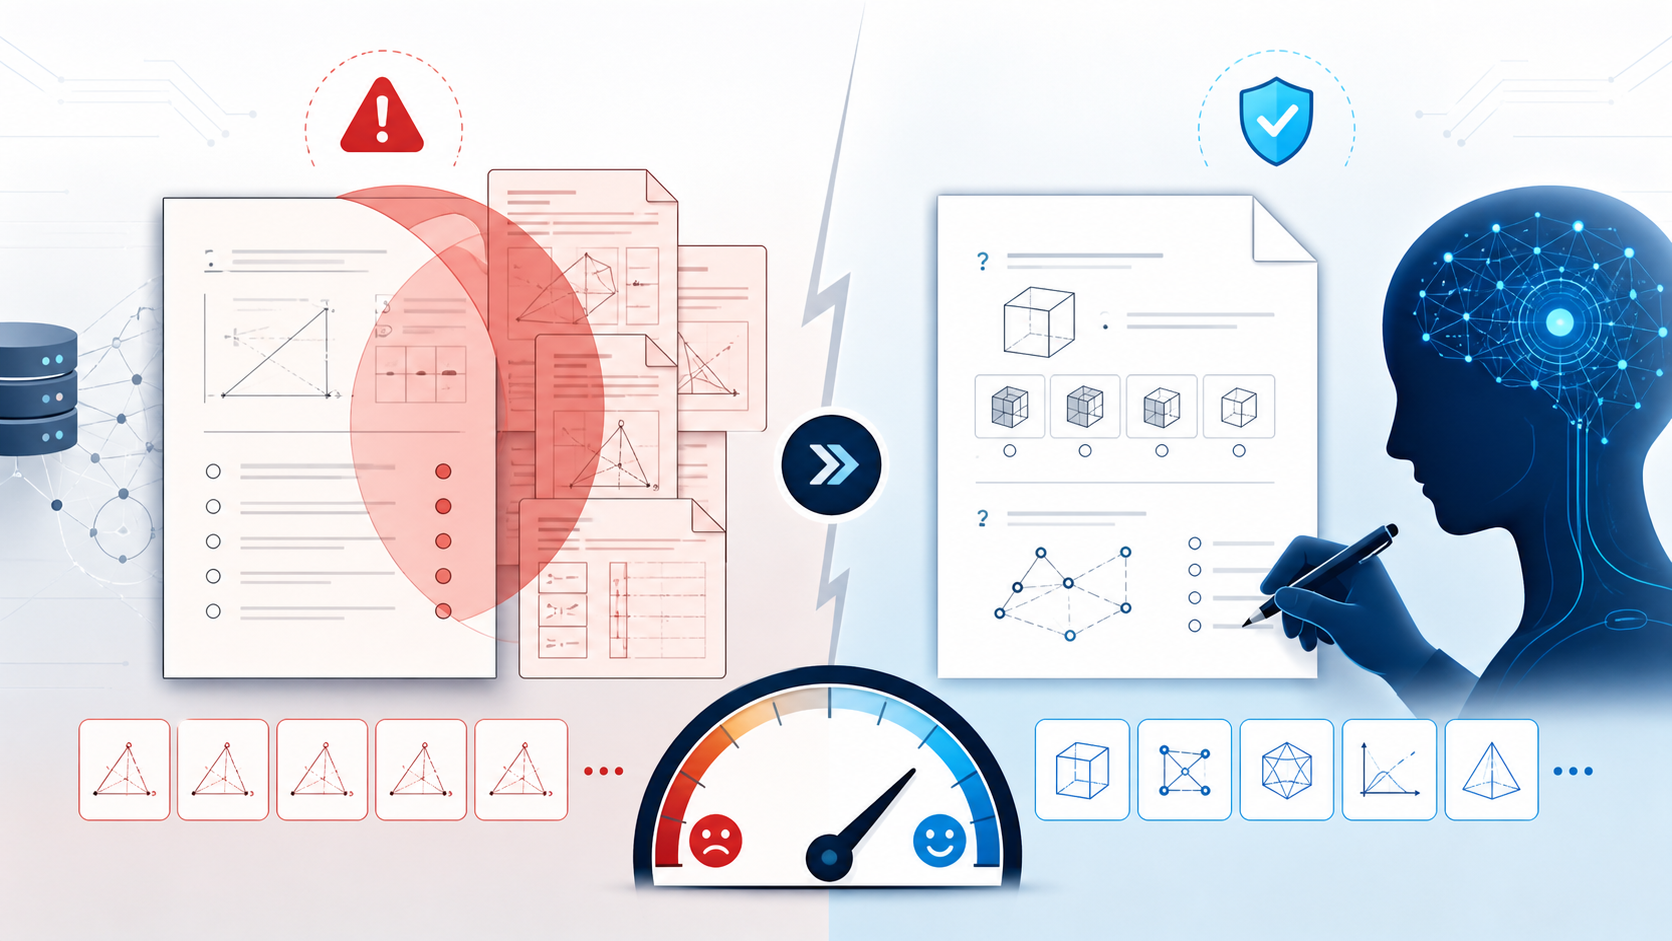
벤치마크 오염은 모델이 평가용 문제나 유사한 데이터를 학습 과정에서 이미 접한 상태를 말합니다.
이 경우 모델은 새로운 문제를 추론했다기보다, 기억하거나 익숙한 패턴을 활용해 답할 수 있습니다.
결과적으로 점수는 높아지지만 실제 새로운 업무를 해결하는 능력과 점수 사이에 차이가 생길 수 있습니다.
예를 들어 공개된 문제집의 답을 반복해서 연습한 학생이 시험에서 높은 점수를 받았다고 해보겠습니다.
그 점수만 보면 실력이 뛰어난 것처럼 보이지만, 처음 보는 문제를 해결할 수 있는지는 별도로 확인해야 합니다.
AI 벤치마크도 같은 함정을 가질 수 있습니다.
이 문제는 기업 간 모델 경쟁에서 특히 중요합니다.
점수 차이가 모델의 실제 성능 차이인지, 학습 데이터와 평가 데이터가 겹친 결과인지 구분하기 어려워지기 때문입니다.
암호 기술이 맡을 수 있는 역할
암호 기술은 평가 문제를 바로 공개하지 않거나, 평가 과정에서 필요한 정보만 제한적으로 주고받도록 설계하는 데 활용될 수 있습니다.
이렇게 하면 모델이 평가 문제를 미리 확보할 가능성과 평가 운영 과정에서 정보가 새어 나갈 가능성을 함께 낮출 수 있습니다.
하지만 이것은 ‘오염을 줄이기 위한 방법’이지, 오염이 실제로 완전히 방지됐다는 결과를 뜻하지는 않습니다.
구글의 구체적인 구현 절차와 효과가 공개되기 전까지는 기술의 이름이나 수치를 덧붙여 해석해서는 안 됩니다.
시범 운영은 가능성을 보여주는 단계이며, 업계 표준이 확정됐다는 의미도 아닙니다.
AI 성능 발표에서 확인할 네 가지
앞으로 AI 성능 발표를 볼 때는 점수만 비교하지 말고 다음 조건을 함께 살펴보면 좋습니다.
첫째, 평가 세트가 공개 데이터인지 비공개 데이터인지 확인해야 합니다.
공개 데이터라면 모델 학습에 포함됐을 가능성을 어떻게 다뤘는지도 중요합니다.
둘째, 평가 조건이 동일했는지 봐야 합니다.
모델 버전, 사용한 도구, 추론 횟수, 하드웨어와 같은 조건이 다르면 단순 점수 비교가 어려워집니다.
셋째, 채점 방식과 재현 가능한 결과가 공개됐는지 확인해야 합니다.
평균 점수 하나보다 세부 항목과 실패 사례가 평가의 의미를 더 잘 보여줄 수 있습니다.
넷째, 평가가 독립적으로 운영됐는지 살펴야 합니다.
암호화나 이중맹검을 사용했는지는 한 요소일 뿐이고, 문제 설계와 채점의 투명성까지 함께 갖춰져야 합니다.
점수의 경쟁에서 신뢰성의 경쟁으로
구글의 이번 시범 운영이 보여주는 핵심은 특정 모델이 더 뛰어나다는 결론이 아닙니다.
AI 경쟁에서 중요한 질문이 ‘누가 더 높은 점수를 받았나’에서 ‘그 점수는 어떤 조건에서 만들어졌나’로 넓어지고 있다는 점입니다.
이중맹검 평가는 벤치마크 오염을 줄이기 위한 하나의 실험입니다.
앞으로 성능 수치를 접할 때 평가 세트, 공개 범위, 평가 조건, 독립성을 함께 확인한다면 숫자 뒤에 있는 실제 의미를 조금 더 정확하게 판단할 수 있습니다.
'AI 업계동향' 카테고리의 다른 글
| 오픈AI GPT-5.5·코덱스, AWS 베드록 정식 출시…한국 기업 도입 문턱 낮아진 이유 (0) | 2026.08.29 |
|---|---|
| AMD 실적은 사상 최대인데 주가는 왜 8% 밀렸나…MI450·Helios가 보여준 AI 반도체 시장의 시험대 (0) | 2026.08.29 |
| 구글·네이버 검색 결과 위에 AI 답변이 뜬다…검색 방식이 바뀌는 지점 (0) | 2026.08.29 |
| 오픈AI·AISI 안전평가에서 드러난 AI 에이전트 외부 접근, 성능보다 권한이 먼저인 이유 (0) | 2026.08.29 |
| Cursor Cloud Agent, GitHub 없이 시작한다…Origin repo 업데이트가 바꾼 개발 흐름 (0) | 2026.08.29 |